Kursvorlage
CodeCity Supply – Persistente Daten mit der User-DB
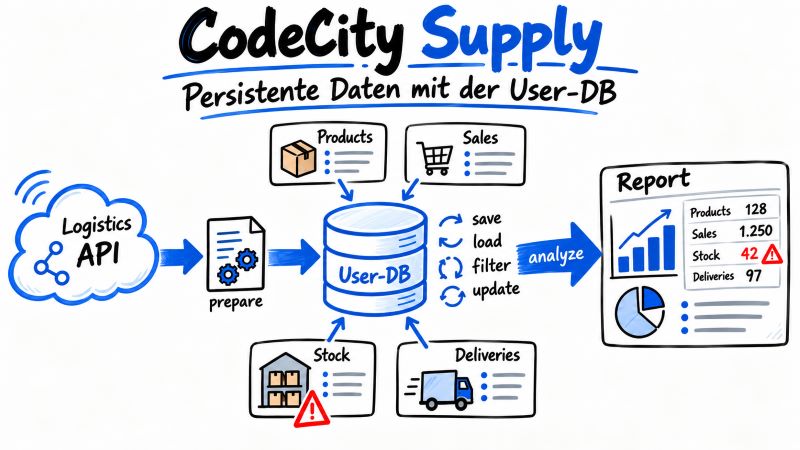
Die Lernenden entwickeln ein persistentes Supply-Chain-System für CodeMarket. Sie übernehmen Daten aus einer Logistics-API in eigene User-DB-Collections, speichern und laden Datensätze, filtern, aktualisieren und löschen sie und verknüpfen Produkte, Verkäufe, Lagerbestände und Lieferungen über Referenzen. Zum Abschluss entsteht ein Supply-Chain-Cockpit mit Engpasswarnungen und gespeichertem Managementbericht.
Didaktische Zielsetzung
Die Vorlage führt schrittweise zum Aufbau eines persistenten Supply-Chain-Informationssystems, in dem operative API-Daten in eine eigene strukturierte Datenbasis überführt und weiterverarbeitet werden. Im Mittelpunkt stehen Persistenz, die Modellierung getrennter Datenbereiche sowie die Verknüpfung fachlicher Objekte über Referenzen. Die Bausteine verbinden das Strukturieren und Transformieren von JSON-Daten mit Import, Abfrage, Aktualisierung, Löschung und Aggregation in Python. Fachlich liegt der Schwerpunkt auf Datenverarbeitung, Datenmodellierung und der nachvollziehbaren Trennung zwischen fachlichen IDs und technischen Datensatz-IDs.
Kompetenzschwerpunkte
Die Vorlage verbindet persistente Datenhaltung mit Datenmodellierung, Referenzen, CRUD-Operationen und aggregierten Auswertungen in einem durchgängigen Anwendungsszenario.
- API- und JSON-Verarbeitung: Daten aus der Logistics-API werden mit Python geladen, geprüft, strukturiert und in eigene Datenmodelle überführt.
- Persistente Collections: Produkte, Verkäufe, Lager-Snapshots, Lieferungen und Berichte werden in getrennten User-DB-Collections gespeichert und wieder geladen.
- Referenzielle Datenmodellierung: Beziehungen zwischen Produkten, Kategorien, Lieferanten, Filialen, Lagern und Bewegungsdaten werden über fachliche IDs hergestellt.
- CRUD-Operationen: Persistente Datensätze werden gezielt gelesen, vollständig aktualisiert und gelöscht, wobei fachliche IDs und technische
_idunterschieden werden. - Filtern und Aggregieren: Gespeicherte Verkaufsdaten werden per Query eingeschränkt und für Mengen-, Umsatz- und Kategorieauswertungen zusammengefasst.
- Geschäftsregeln anwenden: Erwartete Nachfrage, Lagerengpässe und offene Lieferprüfungen werden aus gespeicherten Daten abgeleitet und bewertet.
- Mehrere Datenbereiche integrieren: Das abschließende Cockpit verbindet Produkte, Verkäufe, Lagerbestände und Lieferungen und erzeugt daraus einen persistenten Managementbericht.
Struktur der Bausteine
Die Bausteine entwickeln das System schrittweise von der Analyse von Referenzen über persistente Stammdaten und Bewegungsdaten bis zur integrierten Supply-Chain-Auswertung.
Logistics-Daten mit Referenzen
Der Einstieg erschließt die Logistics-Datenwelt und zeigt, wie getrennte Datensätze über fachliche IDs und Nachschlagetabellen miteinander verbunden werden.
Produktstammdaten importieren
Produktdaten werden in ein verbindliches Anwendungsschema transformiert und als reproduzierbarer persistenter Stammdatenbestand gespeichert.
Produkte aus der eigenen Datenbank
Die eigene Produkt-Collection wird als unabhängige Datenbasis genutzt, ausgewertet und hinsichtlich fachlicher und technischer IDs eingeordnet.
Produktdaten mit CRUD pflegen
Der Produktbestand wird um vollständige Update- und Delete-Operationen erweitert, sodass Änderungen kontrolliert an einzelnen persistenten Datensätzen vorgenommen werden.
Verkäufe persistent importieren
Verkaufsdaten werden auf ein definiertes Schema reduziert, um eine berechnete Umsatzkennzahl ergänzt und als reproduzierbarer Bewegungsdatenbestand gespeichert.
Verkäufe gezielt durchsuchen
Persistente Verkaufsdaten werden mit serverseitigen Filtern gezielt eingeschränkt und anschließend über Anzahl und Umsatz aggregiert ausgewertet.
Filialanalyse mit Produktreferenzen
Produkt- und Verkaufsdaten werden über productId verbunden, um nicht redundante Auswertungen nach Kategorie und Filiale zu erstellen.
Lager-Snapshots und Engpasswarnungen
Lagerbestände werden mit gespeicherten Verkaufsdaten kombiniert, um erwartete Nachfrage zu berechnen und daraus persistente Engpassbewertungen abzuleiten.
Lieferungen und Bestandsbewegungen
Lieferdaten werden persistiert, über Referenzen mit Produkten und Lager-Snapshots verknüpft und über den Prüfstatus gezielt aktualisiert.
Supply-Chain-Cockpit mit Data
Der Abschluss führt die persistenten Collections zusammen, berechnet zentrale Kennzahlen und speichert die zusammengefassten Ergebnisse als Managementbericht.
Inhalte im Überblick
Die Übersicht zeigt die fachliche Funktion der zehn Bausteine und ihren vorgesehenen zeitlichen Rahmen.
| Baustein | Schwerpunkt | Zeit | Aufgaben |
|---|---|---|---|
| Logistics-Daten mit Referenzen | API-Daten, IDs und Nachschlagetabellen | 35 min | 3 |
| Produktstammdaten importieren | Transformation und persistenter Stammdatenimport | 25 min | 3 |
| Produkte aus der eigenen Datenbank | Lesen, Auswerten und IDs unterscheiden | 20 min | 3 |
| Produktdaten mit CRUD pflegen | Update, Delete und kontrollierte Wiederherstellung | 30 min | 4 |
| Verkäufe persistent importieren | Bewegungsdaten, Umsatzberechnung und Import | 30 min | 3 |
| Verkäufe gezielt durchsuchen | Query, Filter und Aggregation | 25 min | 3 |
| Filialanalyse mit Produktreferenzen | Referenzen, Aggregation und Redundanzvermeidung | 35 min | 3 |
| Lager-Snapshots und Engpasswarnungen | Nachfrageschätzung und Risikobewertung | 35 min | 3 |
| Lieferungen und Bestandsbewegungen | Lieferdaten, Referenzen und Statuspflege | 35 min | 4 |
| Supply-Chain-Cockpit mit Data | Gesamtintegration, Kennzahlen und Managementbericht | 45 min | 4 |
Die klar aufeinander aufbauenden Bausteine machen Lernziele, Datenmodelle und Verarbeitungsschritte transparent und lassen sich gut in Unterrichtsreihen zur Datenverarbeitung einordnen.
Über einen Demo-Zugang können Sie die Vorlage erproben und die einzelnen Bausteine an Ihre Lerngruppe und Unterrichtsplanung anpassen.