Kursvorlage
ClimateLab – Persistenz mit der CodeRoom User-DB
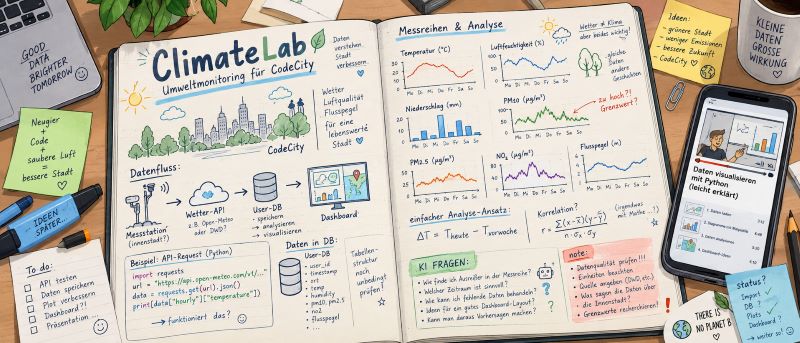
Die Lernenden bauen ein dauerhaftes Umweltarchiv für CodeCity auf und lernen dabei gezielt Persistenz mit der CodeRoom User-DB. Sie übernehmen Wetterdaten aus einer API, speichern und laden Datensätze, filtern, aktualisieren und löschen sie und ergänzen eigene Bewertungen und Notizen. Zum Abschluss entsteht ein kleines Climate Dashboard auf Basis des selbst aufgebauten persistenten Datenbestands.
Didaktische Zielsetzung
Die Vorlage führt schrittweise vom Abruf externer Wetter- und Umweltdaten zum Aufbau eines eigenen, dauerhaft gespeicherten Datenbestands. Im Zentrum stehen Persistenz, die strukturierte Verarbeitung von JSON-Daten sowie das gezielte Speichern, Laden, Filtern, Aktualisieren und Löschen von Datensätzen. Die Bausteine verbinden die Modellierung eines verbindlichen Datenformats mit dessen technischer Umsetzung in Python und der anschließenden Auswertung des selbst aufgebauten Archivs. Fachlich ist die Vorlage für die Sekundarstufe I, Klassen 8–10, angelegt und verbindet Datenverarbeitung, Programmierlogik und Umweltmonitoring in einem durchgängigen Anwendungskontext.
Kompetenzschwerpunkte
Die Vorlage verbindet API-Nutzung, strukturierte Datenhaltung und eigene Auswertungen zu einem schrittweise aufgebauten Datenprojekt.
- API- und JSON-Verarbeitung: Wetter- und Umweltdaten werden per HTTP abgerufen, als JSON verarbeitet und über definierte Felder ausgewertet.
- Persistente Datenhaltung: Messwerte werden in der Collection
weather_measurementsnach einem verbindlichen zwölfteiligen Datenmodell gespeichert. - Zeitreihen verarbeiten: Mehrere Messwerte werden als History-Daten geladen, mit Schleifen aufbereitet und dauerhaft archiviert.
- Daten gezielt abfragen: Gespeicherte Datensätze werden geladen, nach Station gefiltert und für Minimum, Maximum und Mittelwert ausgewertet.
- Daten pflegen: Fachliche Eindeutigkeit und technische ID werden unterschieden, vollständige Datensätze aktualisiert und einzelne Testdatensätze gelöscht.
- Regelbasierte Auswertung: Eigene Statusregeln werden in Funktionen gekapselt, auf gespeicherte Messwerte angewendet und dauerhaft zurückgeschrieben.
- Ergebnisse zusammenführen: Das abschließende Climate Dashboard bündelt Filter, Kennzahlen, Statuswerte, Notizen und automatisch erzeugte Umweltbericht-Aussagen.
Vom API-Aufruf zum eigenen persistenten Informationssystem
ClimateLab eignet sich besonders gut, um Schülerinnen und Schülern zu zeigen, dass Programmierung nicht nur aus Berechnungen und Ausgaben besteht, sondern häufig darin, Daten aus unterschiedlichen Quellen strukturiert zu übernehmen, dauerhaft zu speichern, zu pflegen und später gezielt auszuwerten. Der Kurs beginnt bewusst mit einem leicht nachvollziehbaren API-Aufruf und entwickelt daraus schrittweise ein eigenes Umweltarchiv. Dadurch entsteht ein realistisches Anwendungsszenario, in dem zentrale Themen des Informatikunterrichts unmittelbar zusammenwirken: HTTP-Kommunikation, JSON, Datenmodelle, Persistenz, Schleifen, Bedingungen, Datenqualität und Auswertung.
antwort = requests.get(adresse, headers=headers)
antwort.raise_for_status()
messwert = antwort.json()

temperatur = messwert.get('temperature')
pm10 = messwert.get('pm10')
pm25 = messwert.get('pm25')
no2 = messwert.get('no2')
Bereits der erste API-Zugriff eröffnet einen modernen Zugang zur Datenverarbeitung. Die Lernenden rufen nicht vorbereitete Werte aus einer lokalen Variablen ab, sondern kommunizieren mit einem Webservice über HTTP und verarbeiten dessen Antwort als JSON. Damit wird sichtbar, wie Anwendungen heute Daten austauschen: Eine URL beschreibt eine Ressource, ein Request fordert Daten an und die Antwort wird in eine für das Programm nutzbare Struktur übersetzt. Gleichzeitig lernen Schülerinnen und Schüler mit .get() bewusst auf Felder zuzugreifen und mit potenziell fehlenden Werten umzugehen.
auffaellig = (
    (temperatur is not None and temperatur >= 30)
    or (niederschlag is not None and niederschlag >= 20)
    or (pm10 is not None and pm10 >= 50)
    or (pm25 is not None and pm25 >= 25)
    or (no2 is not None and no2 >= 40)
)

status = 'auffaellig' if auffaellig else 'normal'
Direkt daran schließt eine fachlich interessante Modellierungsfrage an: Wie wird aus Rohdaten eine Bewertung? Die Statusregel verbindet mehrere Messgrößen über boolesche Bedingungen und macht damit deutlich, dass Software häufig fachliche Regeln explizit in Code übersetzt. Besonders wertvoll ist dabei, dass die Schwellen im Projekt als eigene Regeln gekennzeichnet sind. So kann im Unterricht zwischen Daten und Interpretation unterschieden werden: Die API liefert Messwerte, die Bewertung entsteht erst durch ein selbst definiertes Modell.
messung = {
    'stationId': messwert['stationId'],
    'stationName': messwert['stationName'],
    'timestamp': messwert['timestamp'],
    'temperature': messwert['temperature'],
    'humidity': messwert['humidity'],
    'precipitation': messwert['precipitation'],
    'pm10': messwert['pm10'],
    'pm25': messwert['pm25'],
    'no2': messwert['no2'],
    'riverLevel': messwert['riverLevel'],
    'status': status,
    'note': ''
}
Mit dem Übergang zur User-DB wird aus einem flüchtigen API-Aufruf ein persistenter Datenbestand. Besonders geeignet für den Unterricht ist das verbindliche Datenmodell: Jeder Datensatz enthält dieselben zwölf fachlich definierten Felder. Lernende erfahren damit unmittelbar, warum Datenstrukturen vereinbart und konsistent eingehalten werden müssen. Die Datenbank ist hier nicht nur ein technisches Speicherziel, sondern ein zentraler Lerngegenstand: Daten erhalten eine definierte Form, bleiben über Programmläufe hinweg erhalten und können später wieder geladen und weiterverarbeitet werden.
speicherantwort = requests.post(
    daten_url,
    headers=header,
    json=messung
)
Die Speicherung per POST verdeutlicht zugleich die Trennung zwischen lokalem Programm und externem Datendienst. Die Lernenden sehen, dass Persistenz nicht durch eine besondere Python-Variable entsteht, sondern dadurch, dass Daten an ein dauerhaftes Speichersystem übertragen werden. Damit lässt sich sehr gut das grundlegende Prinzip von Client, API und persistentem Backend vermitteln, ohne dass dafür zunächst ein eigener Datenbankserver eingerichtet oder administriert werden muss.
eindeutige_schluessel = set()

for messwert in messwerte:
    aktuelle_station = messwert.get('stationId', station_id)
    zeitpunkt = messwert.get('timestamp')
    schluessel = (aktuelle_station, zeitpunkt)

    if schluessel in eindeutige_schluessel:
        continue

    eindeutige_schluessel.add(schluessel)
Beim Import mehrerer historischer Messwerte kommt ein weiterer zentraler Aspekt professioneller Datenverarbeitung hinzu: Eindeutigkeit und Datenqualität. Die Kombination aus stationId und timestamp bildet einen fachlichen Schlüssel, über den doppelte Datensätze erkannt werden können. Das eröffnet einen sehr guten Zugang zu Datenbankkonzepten, noch bevor relationale Primärschlüssel oder SQL behandelt werden. Schülerinnen und Schüler lernen, dass nicht jede technisch mögliche Speicherung fachlich korrekt ist und dass Datenbestände aktiv auf Konsistenz geprüft werden müssen.
for messwert in daten:
    temperatur = messwert.get('temperature')

    if not isinstance(temperatur, (int, float)):
        continue

    if hoechste_temperatur is None or temperatur > hoechste_temperatur:
        hoechste_temperatur = temperatur
        hoechster_messwert = messwert
Sobald das Archiv aufgebaut ist, wird es selbst zur primären Datenquelle. Der Kurs wechselt damit didaktisch von der Frage „Wie bekomme ich Daten?“ zur Frage „Was kann ich mit meinen gespeicherten Daten herausfinden?“. Die Suche nach dem höchsten Temperaturwert verbindet Schleifen, Datentypprüfung, Vergleichslogik und Zwischenspeicher mit einer echten Datenanalyse-Aufgabe. Besonders sinnvoll ist dabei, dass die Berechnung zunächst explizit erfolgt und nicht sofort auf fertige Statistikbibliotheken ausgelagert wird. So bleibt der zugrunde liegende Algorithmus sichtbar und nachvollziehbar.
def baue_payload(datensatz):
    return {
        feld: datensatz.get(feld)
        for feld in felder
    }

antwort = requests.put(
    url,
    headers=kopf,
    json=payload
)
Mit dem Aktualisieren gespeicherter Datensätze wird das Thema Persistenz konsequent weitergeführt. Lernende erleben, dass Datenbestände nicht statisch sind, sondern gepflegt werden müssen. Der Kurs unterscheidet dabei sinnvoll zwischen fachlichen Feldern und der technischen _id, über die ein konkreter Datensatz adressiert wird. Das ist eine wichtige Vorbereitung auf spätere Datenbankthemen: fachliche Identität und technische Identifikation sind nicht dasselbe. Gleichzeitig wird verständlich, weshalb bei einem vollständigen PUT ein konsistentes Payload erzeugt werden muss.
antwort = requests.delete(url, headers=kopf)
antwort.raise_for_status()
Auch das Löschen ist didaktisch wertvoll, weil damit der vollständige CRUD-Zyklus sichtbar wird: Datensätze werden erzeugt, gelesen, verändert und gezielt entfernt. Die zusätzliche Bestätigung über die technische ID verhindert versehentliche Löschungen und zeigt, dass Datenmanipulation nicht nur technisch möglich, sondern auch kontrolliert und nachvollziehbar gestaltet werden sollte.
temperaturwerte = zahl_liste(messwerte, 'temperature')

temperatur_mittel = (
    sum(temperaturwerte) / len(temperaturwerte)
)

print('Temperatur minimum:', min(temperaturwerte))
print('Temperatur maximum:', max(temperaturwerte))
print('Temperatur mittel:', temperatur_mittel)
Im abschließenden Dashboard werden die zuvor getrennt erarbeiteten Konzepte zu einem kleinen Informationssystem zusammengeführt. Daten werden geladen, gefiltert und für Minimum, Maximum und Mittelwert ausgewertet; Statuswerte und Notizen werden zusätzlich berücksichtigt. Damit entsteht ein wichtiger Perspektivwechsel: Die persistente Datenbank ist nicht Selbstzweck, sondern Grundlage für Auswertung, Interpretation und Bericht. Schülerinnen und Schüler erleben damit einen vollständigen Datenlebenszyklus – vom Erfassen über das Speichern und Pflegen bis hin zur Analyse.
Für Informatiklehrkräfte liegt der besondere Mehrwert des ClimateLab darin, dass zentrale Inhalte moderner Datenverarbeitung in einem einzigen, durchgängigen Projekt zusammenlaufen: REST-APIs, JSON, Datenmodelle, Persistenz, CRUD, fachliche Schlüssel, Datenqualität, Schleifen, Filter und Kennzahlen. Gleichzeitig entfällt die sonst oft notwendige technische Vorbereitung einer eigenen Datenbankumgebung. Die Lernenden arbeiten dennoch mit realistischen Schnittstellen und dauerhaft gespeicherten Daten. Dadurch eignet sich die Vorlage besonders gut, um Persistenz nicht abstrakt zu erklären, sondern als funktionierenden Bestandteil einer eigenen Anwendung erfahrbar zu machen.
Struktur der Bausteine
Die sieben Bausteine bauen aufeinander auf: vom ersten API-Zugriff über den Aufbau und die Pflege eines persistenten Archivs bis zur zusammenfassenden Auswertung im Climate Dashboard.
Wetterdaten per API auswerten
Der Einstieg erschließt Wetter- und Umweltdaten per API, führt in die JSON-Verarbeitung ein und bereitet mit einfachen Bedingungen erste eigene Statusbewertungen vor.
Messwerte dauerhaft speichern
Dieser Baustein überführt einen aktuellen API-Messwert in das verbindliche ClimateLab-Datenmodell und führt die dauerhafte Speicherung in der User-DB ein.
Zeitreihen dauerhaft archivieren
Die Arbeit wird auf mehrere Tagesmesswerte erweitert, sodass Listen, Schleifen, fachliche Schlüssel und der wiederholte Import in ein persistentes Archiv zusammengeführt werden.
Fragen an unser Umweltarchiv
Der eigene Datenbestand wird nun als primäre Quelle genutzt, um Datensätze gezielt abzufragen, zu filtern und mit einfachen statistischen Kennzahlen auszuwerten.
Messwerte prüfen und korrigieren
Die Datenpflege wird vertieft, indem technische und fachliche Identifikation unterschieden sowie vollständige Datensätze gezielt aktualisiert und gelöscht werden.
Umweltwarnungen aus eigenen Daten
Eigene Bewertungsregeln werden in einer Funktion strukturiert, auf gespeicherte Messwerte angewendet und als aktualisierter Status wieder in den Datenbestand übernommen.
Climate Dashboard
Der Abschluss verbindet das persistente Archiv mit Filtern, Kennzahlen, Statuswerten, Notizen und datenbasierten Berichtsaussagen zu einer kompakten Gesamtauswertung.
Inhalte im Überblick
Die Übersicht zeigt die Abfolge der Bausteine, ihre jeweilige Funktion und den vorgesehenen zeitlichen Rahmen.
| Baustein | Schwerpunkt | Zeit | Aufgaben |
|---|---|---|---|
| Wetterdaten per API auswerten | API-Zugriff, JSON-Auswertung und eigene Statusbedingungen | 70 min | 2 |
| Messwerte dauerhaft speichern | Datenmodell und persistente Speicherung | 40 min | 3 |
| Zeitreihen dauerhaft archivieren | History-Daten, Schleifen und Archivierung | 45 min | 2 |
| Fragen an unser Umweltarchiv | Abfragen, Filtern und Kennzahlen | 45 min | 3 |
| Messwerte prüfen und korrigieren | Aktualisieren, Löschen und technische IDs | 45 min | 4 |
| Umweltwarnungen aus eigenen Daten | Regelbasierte Bewertung und Statusaktualisierung | 45 min | 3 |
| Climate Dashboard | Gesamtauswertung und Umweltbericht | 45 min | 3 |
Klare Bausteine und nachvollziehbare Lernziele erleichtern die Einbindung in Unterrichtsreihen zu Datenverarbeitung, Persistenz und Umweltmonitoring.
Über einen Demo-Zugang können Sie die Vorlage erproben und die einzelnen Bausteine an Ihre Lerngruppe und Unterrichtsplanung anpassen.